AIのサービスは、ときどき止まり、それ以上によく混雑します。公式の障害記録でも、2026年9月29日の23時台(日本時間)にClaudeのチャット画面・API・Claude Codeなどでエラーが増えました。
続く9月30日の2時52分から8時14分(日本時間)には、ChatGPT・Codex・APIでエラーが増えています。大手のAIでも、止まることは珍しくありません。
社員がチャット画面で個別に使っているだけなら、復旧まで別の作業をすれば済みます。困るのは、AIを社内の業務システムやワークフローに組み込んでいる場合です。
受注メールの仕分けや見積書の作成をAIに任せていると、AIが止まった時点で業務も止まります。その異変に、取引先から「見積りが届かない」と連絡を受けて初めて気づくこともあります。
この記事では、ChatGPT・Claudeの障害と混雑に備え、AIが止まっても業務を止めないための切り替えの設計をまとめます。止まって困る業務を絞り、別の会社のAIへ自動で切り替える仕組みを入れ、わざと止めて試すのが答えです。
仕様は2026年9月時点の公式情報です。
 久野
備えはすべての業務に要るわけではありません。止まって困る業務を一つ決めるところから始めてください。
- 障害より多い「混雑」と、止まって困る業務の見分け方
- 別のAIへ自動で切り替える方法の選び方
- わざと止めて分かった落とし穴と、備えを進める順番
- 止まったかどうかを公式のページで確かめる方法
AIの不調は四つの形で起きる
各社が公開している障害の記録(ステータスページ)には、全面的な停止より、一部の機能や一部の利用者の不調のほうがずっと多くあります。OpenAIのページには、2026年9月だけで40件を超える記録が並んでいます。
業務に組み込んだAIの不調は、次の四つの形で起きます。
| 不調の形 | 主な症状 | 現場での見え方 | 気づきやすさと影響 |
|---|---|---|---|
| 全面的な障害 | まったく応答しない、エラーが返る | 仕組みが止まり、復旧を待つしかない | 気づきやすい。影響は最も大きい |
| 混雑 | 応答に数十秒かかる、時間切れになる | 「今日はAIが遅い」と感じる | 気づきにくい。影響は大きい |
| 回数の制限 | 一部の依頼が断られる | 処理が一部だけはじかれ、エラーの記録が残る | 気づきにくい。影響は中くらい |
| 一部のモデルの不調 | 特定のモデルだけ失敗する | 特定の業務だけが黙って失敗する | とても気づきにくい。影響は大きい |
警戒したいのは、全面的な障害より、混雑・回数の制限・一部の不調のような「目立たない不調」です。
止まっていれば誰でも気づけますが、「遅いだけ」「たまに失敗するだけ」ではエラーとして表に出にくくなります。原因が分からないまま、現場の負担だけが少しずつ増えていきます。
大きな障害より多いのは混雑
実務でよく出会うのは、完全に止まる障害より、止まってはいないのに異常に重い「混雑」のほうです。当社は、混雑しやすい時期に次の傾向があると見ています。
- 新しいモデルの発表直後:世界中から利用が集まる
- 米国の業務時間帯:日本時間では夜から明け方にあたる
混雑したとき、各社のAPIは次のように返します。混雑は、エラーの番号として業務システムに届きます。
| 会社 | 混雑したときの返し方 |
|---|---|
| Anthropic(Claude) | 全利用者で混み合うと529。自社の利用を急に増やすと429になることがある |
| OpenAI(GPT) | 処理の余力が足りないと503。利用を急に増やすと429(Slow Down) |
| Google(Gemini) | 無料枠の依頼は混雑時に後回しにされ、有料枠の依頼が優先される |
こうした不調が出ていても、ステータスページは「正常」のままということもあります。社内では「今日はAIの動きが悪い」と言われながら、原因が分からないまま一日が過ぎてしまいます。
Geminiを業務で使うなら、無料枠のままにせず、有料枠で契約しておくと混雑の影響を受けにくくなります。
タイムアウトで切り替えて混雑も避ける
別のAIへの自動切り替え(フォールバック)は、障害のときだけの仕組みではありません。応答を待つ時間に上限(タイムアウト)を設ければ、混雑にも効きます。
決めるのは、「決めた秒数のうちに応答がなければ失敗とみなし、別のAIへ回す」というルールです。
当社の検証環境では、応答を待つ上限を5秒、再試行を1回にしました。この設定では、主に使うAIを5秒ずつ2回待ってから、別のAIへ切り替わります。
切り替えを入れるときの注意
自動切り替えを入れるときは、次の二点に注意してください。
一つ目は、どのAIが応答したかを記録することです。切り替えがうまく働くほど、主に使うAIが止まっていても現場は気づきません。
「主に使うAIが落ちたまま、予備のAIで回り続けていた」という事態を防ぐため、応答したAIの割合を毎日見られるようにしておきます。
二つ目は、複数の会社が同時に止まることへの備えです。
公式の記録では、2026年9月3日の夜(日本時間)に、Claudeの複数のモデルのエラー(22時26分〜翌1時23分)とChatGPT・Codexのエラー(23時58分〜翌1時55分)が重なりました。
主に使うAIと予備の二社だけでなく、三つ目まで用意しておくと、こうした重なりにも耐えやすくなります。それでも全部が止まったときのために、最後は手作業に戻す手順も決めておきます。
止まって困る業務を先に絞る
社内のすべてのAI処理に、予備を用意する必要はありません。全部に備えようとすると、開発費も保守の費用も膨らみます。
備えが要る業務の見分け方
どの業務から備えるかは、次の二つで判断します。
- 待てるか:人が応答を待っている業務か、締切が厳しい業務か
- 後戻りできるか:取引先への送信やシステムへの書き込みまで自動で進むか
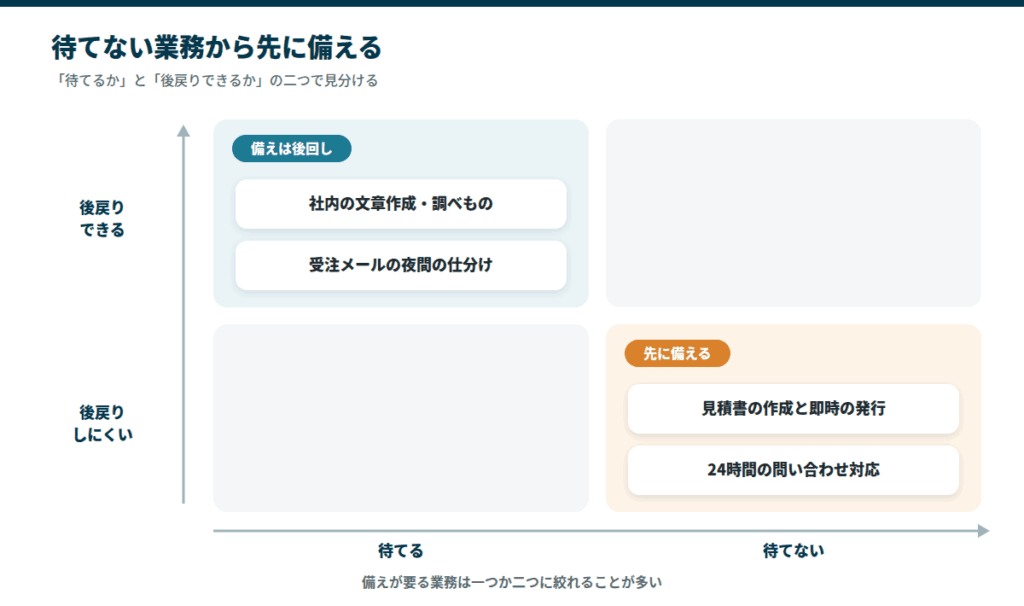
業務ごとに当てはめると、次のようになります。
| 業務の例 | 止まったときの影響 | 備え |
|---|---|---|
| 社内の文章作成・調べもの | 各自が復旧を待つか、自分で書けば済む | 要らない |
| 受注メールの仕分け(夜間にまとめて処理) | 翌朝までに終われば業務は回る | 要らない(後回しでよい) |
| 見積書の作成と即時の発行 | 取引先を待たせ、受注の機会を逃す | 要る |
| 24時間の問い合わせ対応 | 問い合わせが放置され、苦情や信用の低下につながる | 要る |
当てはめてみると、本当に備えが要る業務は一つか二つに絞れることが多いと当社は見ています。まずは、いちばん困る業務を一つ決めてください。
止まったかどうかは公式のページで確かめる
「今、AIが止まっているのか?」を確かめるいちばん確実な場所は、各社のステータスページです。SNSの投稿を探すより先に、公式のページを開いてください。
表示は「正常」「性能の低下」「一部停止」「全面停止」のように分かれています。障害が起きると、調査中から復旧までの経過が順に書き足されていきます。
ChatGPT・Claude・Geminiのステータスページは、次のとおりです。
| サービス | ステータスページ | 載っている項目 | 通知の受け方 |
|---|---|---|---|
| ChatGPT・OpenAI API | status.openai.com | API、ChatGPT、Codex など | メール、Slack、RSS(項目ごとに選べる) |
| Claude・Claude API | status.claude.com | claude.ai、Claude Console、Claude API、Claude Code、Claude Cowork など | メール、SMS、Slack、Microsoft Teams、Webhook、RSS |
| Gemini API・Google AI Studio | aistudio.google.com/status | API、Multimodal Live API、Google AI Studio | ページ上に登録の窓口はない |
業務でAPIを使っているなら、通知を担当者のメールやチャットへ届くようにしておくと、取引先より先に気づけます。見るのは、自社が使っている項目(APIか、チャット画面か)です。
同じ障害でも、項目ごとに復旧の時刻は違います。公式の記録では、2026年4月15日のClaudeの障害でAPIは約1時間で戻りましたが、チャット画面と管理画面の停止はその後も続きました。
Claudeのページの時刻は協定世界時(UTC)で表示されるため、日本時間は9時間足して読みます。OpenAIのページは、見ているパソコンやスマホの時刻で表示されます。
ページが「正常」でも、自社だけ動かないことはあります。OpenAIは稼働率を「全プラン・モデル・エラーの種類を合算した値」と説明しており、一部のモデルや一部の利用者だけの不調は表に出にくいためです。
業務システムからAPIを呼んでいる場合は、返ってきたエラーの番号で、相手の障害か自社側の問題かをある程度見分けられます。
| エラーの番号 | 主な意味 | 疑う場所 |
|---|---|---|
| 400(Claude) | 組織やワークスペースで決めた利用額の上限に達した(ほかに依頼の書き方の誤りでも返る) | 自社の上限の設定 |
| 429 | 回数の上限、利用額の上限に達した。利用を急に増やしたときにも返る | 自社の使い方や上限の設定 |
| 500 | 提供元のシステムの内部エラー | 提供元(ステータスページを見る) |
| 503(OpenAI)・529(Claude) | 提供元が混み合っている | 提供元の混雑 |
出典:Claude API Docs、OpenAI API Docs
400や429は、自社で決めた利用額の上限に達したときにも返ります。障害だと思って待っていたら、実は上限の設定だったということもあるので、先に自社の設定を確かめてください。
止まったときに手作業へ戻す手順
自動切り替えを入れる業務も入れない業務も、AIが使えないときに人がどう処理するかを決めておきます。決まっていないと、止まったあとに誰も動けません。
業務ごとに一行で足ります。下は記入例です。
| 業務 | 止めると決める人 | 手作業の方法 | 取引先への連絡 |
|---|---|---|---|
| 見積書の作成 | 営業の責任者 | 単価表から手で作り、上長が確かめる | 遅れる場合は当日中に電話で伝える |
| 問い合わせ対応 | 問い合わせの担当者 | 自動の返信を止め、受付の定型文だけ送る | サイトに「返信が遅れています」と出す |
止めると決める人は、一人に絞らず二人以上決めておくと、不在のときにも動けます。
SLAがあっても止まらないとは限らない
「止まらない保証があるプランにすればよい」と考える方もいるかもしれません。しかし、ふつうに申し込んだAPIには、稼働率の保証(SLA)が付いていないのが一般的です。
| サービス | 稼働率の約束 | 対象 |
|---|---|---|
| Claude API(標準) | 保証なし(最善努力) | すべての利用者 |
| Claude API(Priority Tier) | 99.5%を目標 | 容量を契約済みの組織。新しい申し込みは受け付けていない |
| OpenAI API(Scale Tier) | 99.9%のSLA | Enterprise向け |
| Amazon Bedrock | リージョンごとに月99.9% | AWSの利用者 |
SLAは、下回ったときに料金の一部を返す約束です。たとえばAmazon Bedrockでは、月の稼働率が99.9%を下回ると10%、99%を下回ると25%、95%を下回ると100%が、次回以降の請求から差し引かれます。
99.9%は、30日の月でおよそ43分の停止にあたります。SLAがあっても止まるときは止まるので、止まっても業務が進む仕組みは自社で用意します。
自動で切り替える方法を選ぶ
主に使うAIが止まったり混雑したりしたとき、別のAIへ依頼を回す方法はいくつかあります。会社の規模や、今ある仕組みに合わせて選びます。
| 方法 | 中身 | 費用の目安 | 向いている状況 |
|---|---|---|---|
| 手で切り替える | 担当者が障害に気づき、設定を書き換える | かからない | 止まっても半日以上待てる業務 |
| 各アプリに直接書く | プログラムに「Aが失敗したらBを呼ぶ」と書く | 改修費のみ | AIを使う社内システムが一つだけ |
| 社内に窓口を置く(当社の勧め) | AIの呼び出し口を一か所に集め、そこで切り替える | 構築費と月々の保守費 | 複数の社内システムでAIを使っている |
| 中継サービスを使う | 複数のAIを取り次ぐ事業者を経由する | 利用料と手数料 | 開発の人手がなく、小さく始めたい |
| 大手クラウドの基盤を使う | Amazon Bedrockなどで複数社のモデルを一つの契約で使う | 従量課金 | すでにそのクラウドで仕組みを動かしている |
| ローカルAIを予備に置く | 社内のパソコンでAIを動かす | 機材による | 外のAIが全部止まっても動かしたい業務 |
窓口・中継サービス・大手クラウドは、きれいに分かれるものではなく、組み合わせて使うこともあります。LiteLLM・OpenRouter・Amazon Bedrockなどの製品ごとの違いは、次の記事で比べています。
当社が社内の窓口を勧める理由
当社がお客様に提案するとき、主に勧めているのは社内に窓口(LLMゲートウェイ)を置く方法です。理由は三つあります。
- アプリを直さずに済む:各業務アプリは社内の窓口を呼ぶだけなので、AIを入れ替えてもアプリは変わらない
- 利用量と費用をまとめて見られる:部署や仕組みごとの利用量や上限を、一か所で管理できる
- データと契約を自社に置ける:中継の事業者を通さず、各AIとの契約も自社の名義のまま持てる
社内システムが一つだけなら、アプリに直接書く方法でも足ります。ただし、AIを使う仕組みが増えるたびに、同じ切り替えの処理を作り直すコストがかかる点に注意してください。
切り替えはこう動く
社内に窓口を置いた場合、処理は次の図のように流れます。
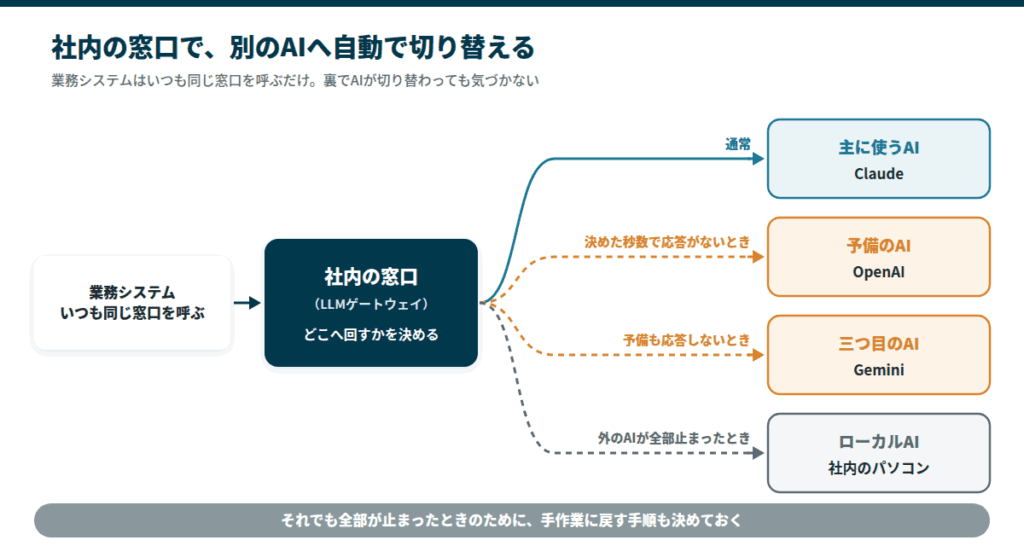
業務システムはいつも同じ窓口を呼んでいるだけなので、裏でAIが切り替わっても気づきません。あとからAIの契約を増やしたり減らしたりしても、業務システムを直す必要はありません。
当社の検証環境では、主に使うAI(Claude)のAPIキーをわざと効かなくした状態で、業務の依頼を送りました。処理はエラーにならず、予備のAIが応答して最後まで終わりました。
ただし、応答は主に使うAIの失敗を待つぶん遅れます。その遅れを含め、わざと止めて分かったことを次の節にまとめます。
わざと止めて分かった落とし穴
ここからは、実際に仕組みを作り、わざと壊して試したことで分かった落とし穴を紹介します。設定しただけでは、次の三つに気づけません。
検証の設定や数字の詳細は、次の記事に記録しています。
失敗を待つ時間が毎回上乗せされる
切り替えは自動で行われますが、仕組みはまず主に使うAIを試します。主に使うAIが止まっていると、失敗と判断するまでの待ち時間が、呼び出しのたびに発生します。
当社の検証(応答を待つ上限5秒・再試行1回)では、1回の呼び出しにつき約12秒の遅れが上乗せされました。
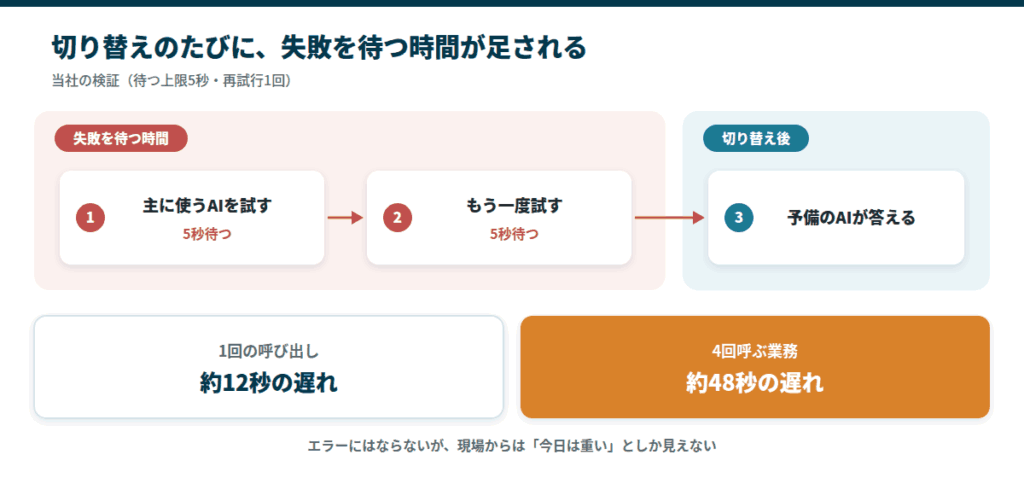
AIが自分で調べたり考えたりを繰り返すエージェント型の仕組みでは、一つの業務で内部のAIを4回ほど呼ぶことがあります。その場合、12秒の4回分で約48秒の遅れになります。
仕組みとしてはエラーにならずに動いていても、現場からは「画面が固まった」「今日は重い」としか見えません。待ち時間の上限と再試行の回数は短めにし、画面には処理中の表示を出すといった配慮が要ります。
途中で切れても成功として返る
チャット画面のように文字が順に表示されるストリーミングという返し方では、厄介なことが起きます。
当社の検証では、応答が途中で切れたのに、仕組みの上では正常に終わったものとして返ってくる場合がありました。
Anthropicも、ストリーミングでは正常の合図(200)を返したあとにエラーが起こりうると説明しています(出典:Claude API Docs)。
人が画面で読んでいれば、文章が途中で途切れていることにすぐ気づけます。しかし、システム同士の連携では、途切れたデータが正しい結果としてデータベースや次の工程へ渡ってしまいます。
システム同士でつなぐ処理ではストリーミングを避け、応答が最後まで返ったことを確かめてから受け取るようにします。
切り替え先の単価と上限を決めておく
自動で切り替わると、依頼の送り先と一緒に、請求の相手も切り替わります。
切り替え先のAIの単価が主に使うAIより高ければ、障害の間だけ費用が増えます。
逆に、ふだん使わない予備のアカウントで利用額の上限を低くしたままだと、切り替わった途端に上限のエラー(429など)で止まるという二重の障害になります。
予備のアカウントにも、あらかじめ上限と、上限に近づいたときの知らせを設定しておきます。単価の比べ方と上限の設定は、AI API料金比較と高額請求の防ぎ方で紹介しています。
備えを進める順番
AIの障害や混雑への備えは、一度にすべてを作ろうとせず、次の順番で一つずつ進めると確実です。
- 止まって困る業務を一つ決める:影響の大きい業務を一つだけ選ぶ
- 気づき方を決める:ステータスページの通知や、処理が止まったときの知らせを誰が受けるか決める
- 予備のAIを一社契約して試す:別の会社のAIで、同じ指示から正しい結果が出るか確かめる
- 自動の切り替えを組み込む:待ち時間の上限などを決め、自動で切り替わるようにする
- わざと止めて試す:主に使うAIのAPIキーを効かなくするなどして、本当に切り替わるか確かめる
- 応答したAIの割合を毎日見る:どのAIが何割応答したかを記録し、毎日見られるようにする
とくに大切なのは、わざと止めて試すことと、応答の割合を見続けることです。設定しただけで安心すると、いざというときに切り替わらなかったり、予備のAIで回り続けて高い請求に気づかなかったりします。
予備のAIを選ぶときは、業務に合うLLMの選び方で紹介した、業務ごとに試して比べる方法が使えます。応答の割合を毎月の点検に入れる方法は、導入後の月次点検で扱っています。
予備のAPIを一社増やすだけなら、費用は使った分だけの従量課金が基本で、月々の固定費は大きく増えません。
久野わざと止めて試すまでが備えです。当社の検証でも、設定しただけでは気づけない落とし穴が三つ見つかりました。
まとめ
- 業務に組み込んだAIは、全面的な障害より、混雑や一部の不調で止まることが多い
- 備えるのは、待てず後戻りしにくい業務に絞る。止まったときに確かめる場所と、手作業の手順も決める
- 別の会社のAIへ自動で切り替える仕組みを入れ、わざと止めて試し、応答の割合を見続ける
AIのサービスは強力な道具ですが、止まることも混雑することもあるという前提で使い方を決める必要があります。SLAが付いていても、止まらないとは限りません。
すべての業務に備えようとすると、費用も手間も膨らみます。まずは止まっていちばん困る業務を一つ選び、小さな備えから始めてください。