「AIエージェントに向いたLLMは、本当にあるのか?」という問いを、当社はここ数か月ずっと抱えていました。
お客様のシステムでどのモデルを使うかは、開発を担う当社が決めます。そのため、動かしたあとの安定性や費用の責任も当社に残ります。
ところが、判断の材料はネット上の評判や、詳しい人の経験談に頼りがちでした。公開されているベンチマークの数字も無意味ではありませんが、実際の業務の流れに沿って測ったものではありません。
見積りを作り、在庫を確かめ、受発注のメールを下書きするまでを続けて進める業務で、モデルを比べたデータは見当たりませんでした。そこで、自社の業務を模した環境を作り、3社のモデルに同じ30件のタスクを3回ずつ解かせました。
比べたのは、ChatGPTなどの画面で使うサービスではなく、システムからAPIで呼び出したときのLLM(大規模言語モデル)です。生成AIの性能比較として、GPT、Claude、Geminiを同じ条件で並べています。
検証は半日で終わる規模に絞り、費用も1モデルあたり10ドル以内に収めました。それでも結果は、事前の予想と大きく違いました。
検証の数字は2026年9月18日時点のモデルでの実測です。今の各社のモデルと料金は2026年9月時点の公式情報で、円は1ドル=156円(2026年9月18日の相場)で換算しています。
- GPT・Claude・Geminiを業務タスクで比べた結果
- 差が出た「手順の遵守」と「止まり方」
- 単価表と実際の費用が逆転した理由
- 2026年9月時点の各社のモデルと、用途ごとの使い分け
業務タスクでのLLM性能比較
先に結果をまとめます。結果の正しさでは3社の差は小さく、差が出たのは確認の手順を省かないかと、エラーのときに止まれるかでした。
| モデル(検証時) | 結果の正しさ | 手順の遵守 | 止まれなかった失敗 | 成功1件あたりの費用 | 所要時間の中央値 |
|---|---|---|---|---|---|
| Claude(claude-sonnet-5) | 98% | 94% | 0件 | 約2.5円 | 5.0秒 |
| GPT(gpt-5.6-terra) | 92% | 82% | 0件 | 約1.6円 | 4.6秒 |
| Gemini(gemini-3.8-flash) | 97% | 91% | 3件 | 約3.6円 | 6.3秒 |
費用は単価表の順にならず、単価が最も安いGeminiが、成功1件あたりでは最も高くなりました。出力が長いことと、プロンプトキャッシュが効きにくかったことが理由です。
この結果から、当社は一回で終わる処理にはGPTかGemini、書き込みを伴うエージェントにはClaudeを第一に選んでいます。使い分けの詳しい決まりは、後半の「用途ごとのモデルの使い分け」の節にまとめました。
 久野
この比較は、検証した時点のモデルでの結果です。モデルは数か月で入れ替わるので、自社の業務で一度測ってから決めてください。
検証したモデルと今のモデル
検証には、各社の最上位ではなく、業務でよく使われる中位のモデルを選びました。検証のあとに各社のモデルが入れ替わっているため、当時のモデルと今のモデルを分けて示します。
検証に使ったモデル
次の三つは、2026年9月18日時点のモデルです。単価も当時のものです。
| 提供元 | モデルID | 入力/出力の単価(100万トークンあたり) |
|---|---|---|
| Anthropic | claude-sonnet-5 | $2.00/$10.00 |
| OpenAI | gpt-5.6-terra | $2.00/$12.00 |
gemini-3.8-flash | $0.75/$3.75 |
システムプロンプト(AIへの指示文)と Temperature(出力のばらつきの設定)は、3モデルとも同じ値に固定しました。与えた指示文は一字一句同じです。
今の各社のモデルと料金
2026年9月時点の各社の主なモデルと料金は、次のとおりです。
| モデル(2026年9月時点・公式) | 入力 | 出力 | 検証のモデルとの関係 |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | 最上位 |
| Claude Opus 5.5 | $4 | $20 | 上位 |
| Claude Sonnet 5.5 | $2 | $10 | Sonnet 5の後継で、同じ単価 |
| Claude Haiku 4.5 | $1 | $5 | 軽量 |
| GPT-6 Astra | $10 | $50 | 最上位 |
| GPT-6.1 Sol | $2 | $10 | 中位。gpt-5.6-terraの次の世代 |
| GPT-6 Luna | $0.10 | $0.50 | 軽量 |
| Gemini 3.1 Pro Preview | $2 | $12 | 上位(プレビュー版) |
| Gemini 3.8 Flash | $0.75 | $3.75 | 検証と同じモデル |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 軽量 |
Anthropicの料金ページでは、検証に使ったClaude Sonnet 5は旧世代の欄に移りました。
OpenAIの開発者向けの料金ページはGPT-6の世代に替わり、GPT-6.1 Solは2026年9月29日に公開されたばかりです。
Gemini 3.8 Flashは、2027年1月1日から入力$1.50・出力$7.50に値上げされると予告されています。今回の費用の比較は、値上げ前の単価での結果です。
中位のモデルは、3社とも入力$2・出力$10前後に並びました。キャッシュやバッチの割引を含めた料金は、AI API料金比較でまとめています。
よく言われる評判と、測った理由
検証の前に、世の中でよく言われるモデルごとの特徴を整理しておきます。そのうえで、評判だけでは選べない理由を示します。
各社のモデルの評判
次の表は当社の見解ではなく、技術系のメディアや記事でよく見かける主張をまとめたものです。
| モデル | よく言われる評判 |
|---|---|
| GPT(ChatGPT) | 計画から実行・確認までを一つのモデルで済ませやすい万能型。エージェントの標準として紹介されることが多い |
| Claude | ツールの呼び出しが正確で、手順の多い作業でエラーが少ない。やり直しが減るため、単価が高くても総額では有利という解説もある |
| Gemini | 費用の安さで選ばれる。普段の処理はGeminiで回し、込み入った推論だけをClaudeに回す構成が勧められやすい |
| 日本語の精度 | 用途によって差が出るため、最後は自社のデータで確かめるべきと添えられることが多い |
どれももっともらしく聞こえますが、互いに食い違う意見も多くあります。何より、実際の業務で何が起きるかを数字で示したものではありません。そのため、自社の環境で測ることにしました。
単発の処理とエージェントで評価が違う
当社の業務システムに届くAIへの依頼は、大きく二つに分かれます。
- 単発タスク:問い合わせメールの分類、注文メールからの抜き出しなど
- エージェントタスク:在庫を確かめ、見積りを作り、確認メールを下書きする一連の処理
二つでは、評価すべき点が違います。
| 評価の軸 | 単発タスク | エージェントタスク |
|---|---|---|
| 正確さ | 回答が正しいか? | 一連の業務を最後まで正しくやり切れたか? |
| 速さ | 最初の応答までの時間 | タスクが終わるまでの時間 |
| 費用 | 1回の依頼あたりの単価 | 1タスクあたりの合計 |
| 失敗の出方 | 単純な誤り・読み飛ばし | 止まらずに、誤った判断のまま最後まで進む |
エージェントタスクでは、やり取りが続くたびに、会話の履歴やツールの結果が入力に積み重なっていきます。入力のトークンが回を追うごとに増えるため、料金表の単価よりも、プロンプトキャッシュがどれだけ効くかで請求額が決まります。
業務を模した検証の方法
検証のために、部品商社の事務を模した簡単な業務システムを一つ作りました。実行の流れは次のとおりです。
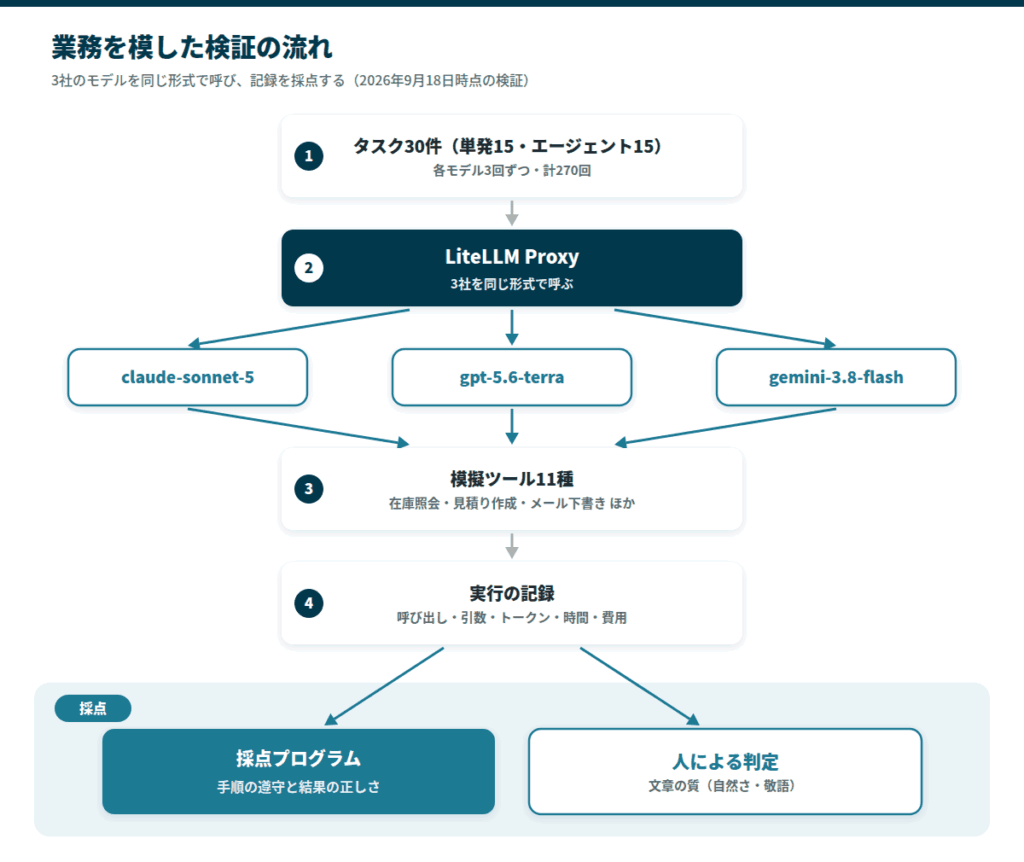
- 実行プログラムがタスクを順に読み込む
LiteLLM Proxyを通して、3社のモデルを同じ形式で呼び出す- 各モデルが模擬ツール(Function Calling)を呼び出しながらタスクを進める
- ツールの呼び出し・引数・トークン数・時間・費用をすべて記録する
- 採点プログラムが記録を読み、合否を判定する
- 自動で判定しにくい文章の質だけ、人が読んで判定する
模擬ツールと意地悪な条件
エージェントが使うツールとして、どれもダミーのデータを返す11種類の関数を用意しました。
| 種類 | ツール |
|---|---|
| 検索・照会 | 顧客検索、商品検索、在庫照会、納期照会、注文履歴、注文状況、カレンダー |
| 更新・書き込み | 見積り作成、受注登録、予定登録、メール下書き |
データには、現場でよく起こる意地悪な条件をあらかじめ入れてあります。
- 「山田」で検索すると「山田工務店」「山田電機」の2社が出る
- 存在しない品番(
P-777)を指定するとエラーを返す - 在庫がマイナス、単価が0円の商品(
P-999)がある - 1回目だけ通信エラーを返すツールと、ずっとエラーを返すツール
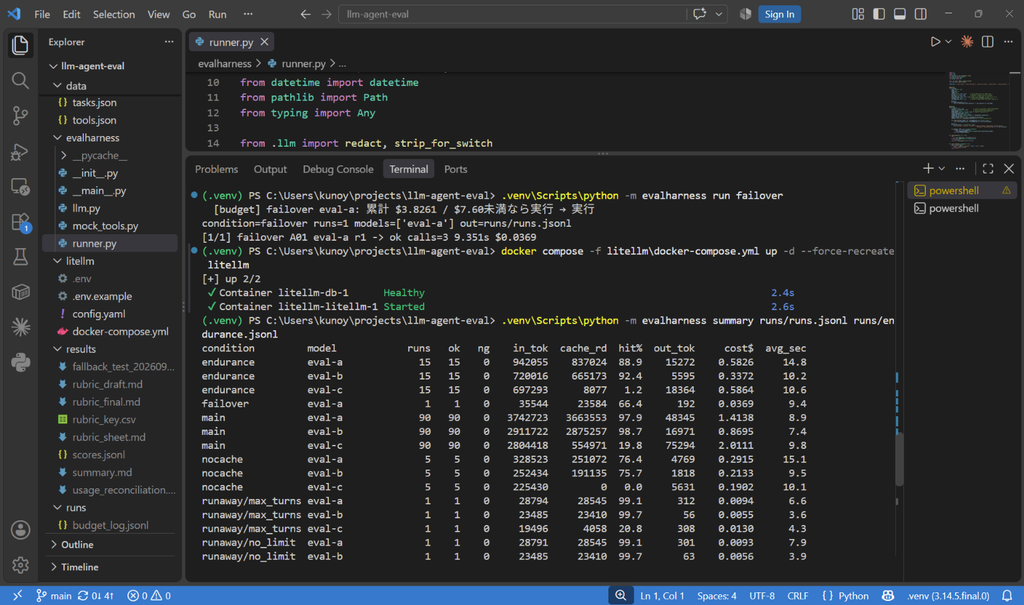
各タスクを3回ずつ実行し、合計270回の実行の記録を取りました。このほかに、続けて動かす条件、キャッシュを壊した条件、途中でモデルを入れ替える条件も試しています。
採点の基準を三度直した
検証を進めるうちに採点の基準の難しさに気づき、基準を三度見直しました。
最初の基準では、タスクごとに使ってよいツールを決め、それ以外を呼んだら不合格にしていました。この基準だと、Geminiのエージェントタスクの成功率は60%まで下がりました。
ところが、落ちた記録を読むと、Geminiは在庫を確かめるついでに、念のため納期照会も一緒に呼んでいました。業務としては妥当な動きで、問題は出題の側にありました。
そこで、書き込みを伴うツール(見積り作成・受注登録・予定登録・メール下書き)だけを厳しく判定し、読み取りだけのツールを余分に呼ぶのは許す形に直しました。新しい基準で、Geminiの成功率は大きく持ち直しました。そのあとも判定の細部を二度直しており、最終の結果は次の表のとおりです。
評価では、次の二つを分けています。
- 手順の遵守:確認の手順を含め、指示どおりの順番で進めたか
- 結果の正しさ:最後の出力と書き込みの内容が正しいか
比較の記事を読むときは、何を不合格の条件にしているかを確かめてください。同じ記録でも、基準しだいで成功率は大きく変わります。
文章の質は人が判定した
自動で判定できない文章の自然さや敬語の適切さは、人が読んで判定しました。偏りを防ぐため、Claudeに判定の下書きを作らせたうえでモデル名を伏せています。
最後は筆者(久野)が36件の文面をすべて読んで決めました。
差が出たのは手順と止まり方
結果の正しさだけを見ると、3社はほぼ横並びでした。差が出たのは、確認の手順を守ったかと、止まるべき場面で止まれたかです。
結果の正しさはほぼ横並び
まず、結果の正しさの比較です。
| モデル | 全体 | 単発タスク | エージェントタスク |
|---|---|---|---|
| Claude | 88/90(98%) | 44/45 | 44/45 |
| Gemini | 87/90(97%) | 45/45 | 42/45 |
| GPT | 83/90(92%) | 39/45 | 44/45 |
エージェントタスクの正解は3社とも42〜44件(93%以上)に収まり、ほぼ横並びです。985回のツールの呼び出しで、引数の型や形式を間違える「スキーマ違反」は3モデルとも0件でした。
この価格帯の中位のモデルでは、どれが一番賢いかで選ぶ段階は終わったと感じています。
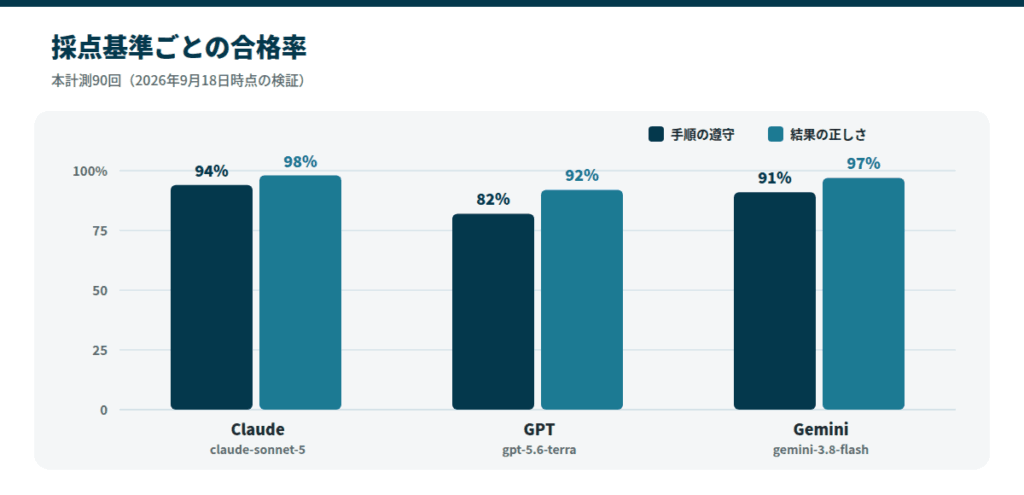
ところが、決められた確認の手順を踏んだかまで見ると、はっきりした差が出ます。
| モデル | 手順の遵守 | 結果の正しさ |
|---|---|---|
| Claude | 85/90(94%) | 88/90(98%) |
| Gemini | 82/90(91%) | 87/90(97%) |
| GPT | 74/90(82%) | 83/90(92%) |
在庫を確かめずに見積りを作る
手順の遵守を下げた一番の原因は、在庫照会を呼ばずに、いきなり見積り作成を呼ぶ省略でした。
この省略は3モデルで延べ34回起き、内訳はGPTが17回、Geminiが10回、Claudeが7回です。
見積りの計算は正しく動くため金額は合ってしまいますが、在庫を確かめずに取引先に出す書類を作るのは、実務では重大なルール違反です。
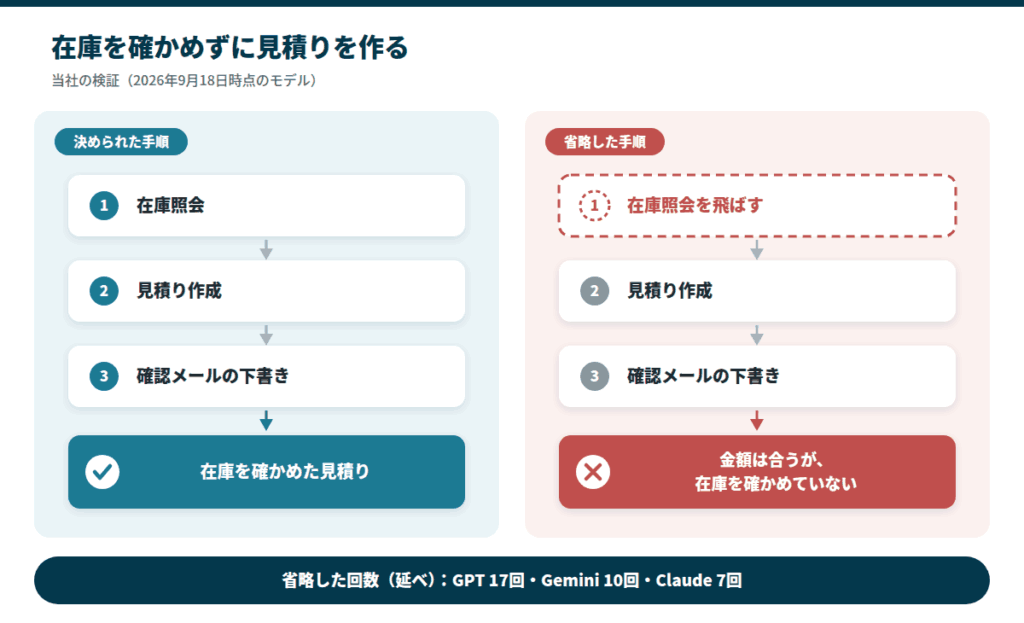
存在しない品番でも見積りを作る
さらに深刻な、止まるべき場面で止まらない失敗が3件起き、すべてGeminiでした。
存在しない品番(P-777)を指定したタスクで、ツールは「該当品番なし」のエラーを返しています。それでもGeminiはエラーを無視して、3回とも見積りを作りました。
見積り作成は書き込みを伴う操作です。実際の運用なら、誤った見積書が取引先に自動で送られるおそれがあります。
自動の採点をすり抜けた文章
社内メモを取引先向けの敬語のメールに直すタスクでは、自動の採点では3モデルとも全件が合格でした。ところが人が文面を読むと、Geminiの2件はビジネスメールとして不十分でした。
- 当社が請求書を送っていないのに、相手が受け取っていないかのような文になった
- 元の社内メモにない事実が書き足されていた
人が判定した文章のタスクの結果は、次のとおりです。
| タスク | Claude | GPT | Gemini |
|---|---|---|---|
| 翻訳・要約・分類 | 3/3 | 3/3 | 3/3 |
| 議事録の構造化 | 3/3 | 0/3 | 3/3 |
| 文章の書き換え | 3/3 | 3/3 | 1/3 |
| 形式の遵守 | 3/3 | 2/3 | 3/3 |
GPTの議事録の構造化は、項目を分けることに3回とも失敗しました。Geminiの文章の書き換えで落ちた2件は、上に挙げた誤った表現です。
社外に送る文章を作る部分は、どのモデルを使うにしても、人の確認を入れる前提で設計してください。送る前に人が止める仕組みは、送る前に止める業務自動化の設計で紹介しています。
失敗の多くは毎回同じ形で起きる
結果の正しさで落ちた失敗は、3社で合わせて12件でした。そのうち9件(75%)は、3回の実行で毎回同じ失敗をくり返しました。
- 存在しない品番で見積りを作る
- 込み入った住所の表記を正しく整えられない
- 会議メモから決定事項を抜き出す数を間違える
偶然のぶれではなく、モデルの苦手な型や、指示の読み方の癖から来る失敗が大半です。
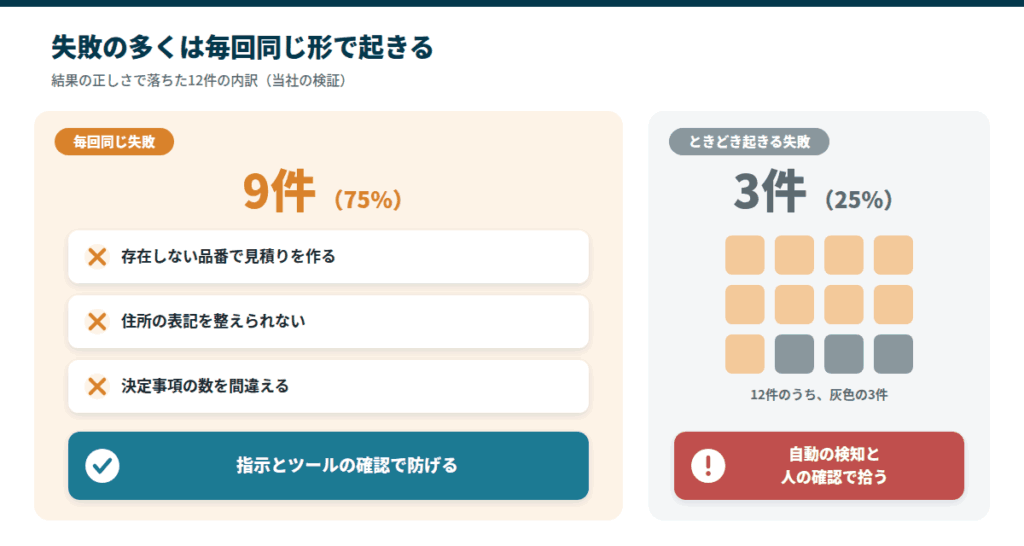
失敗の型が決まっているなら、指示文の調整やツールの側の確認で防げます。一方、残りの25%のような時々起きる失敗には、システムでの自動の検知や、人の見張りと代わりの手段を用意しておく必要があります。
費用と処理時間
費用と処理時間も、単価表や評判とは違う結果になりました。
費用は単価表の順にならない
次の表は、1タスクの実行にかかったAPIの利用料の実測です。
| モデル | 1回の実行あたりの平均 | 成功1件あたり |
|---|---|---|
| GPT(gpt-5.6-terra) | $0.0097 | $0.0105(約1.6円) |
| Claude(claude-sonnet-5) | $0.0157 | $0.0161(約2.5円) |
| Gemini(gemini-3.8-flash) | $0.0223 | $0.0231(約3.6円) |
料金表の単価が最も安いGeminiが、実際の運用では最も高くつくという逆転が起きました。Geminiの入力の単価はClaudeの半分以下なのに高くなった理由は、二つあります。
- 出力が長い:同じ90回で、Geminiの出力トークンはClaudeの1.6倍、GPTの4.4倍
- キャッシュが効きにくい:入力の再利用率はClaude 97.9%、GPT 98.7%、Gemini 19.8%
出力が長いのは、考えた過程や説明を多く返すためです。エージェントでは会話の履歴を毎回丸ごと送り直すので、プロンプトキャッシュが効くかどうかで、請求額は数倍変わります。
Googleの公式ドキュメントでは、Gemini 3.xの自動のキャッシュは4,096トークン以上の入力でないと効かないとされています。当社は低いヒット率の原因を切り分けていませんが、短い指示文で使うときは確かめておくべき条件です。
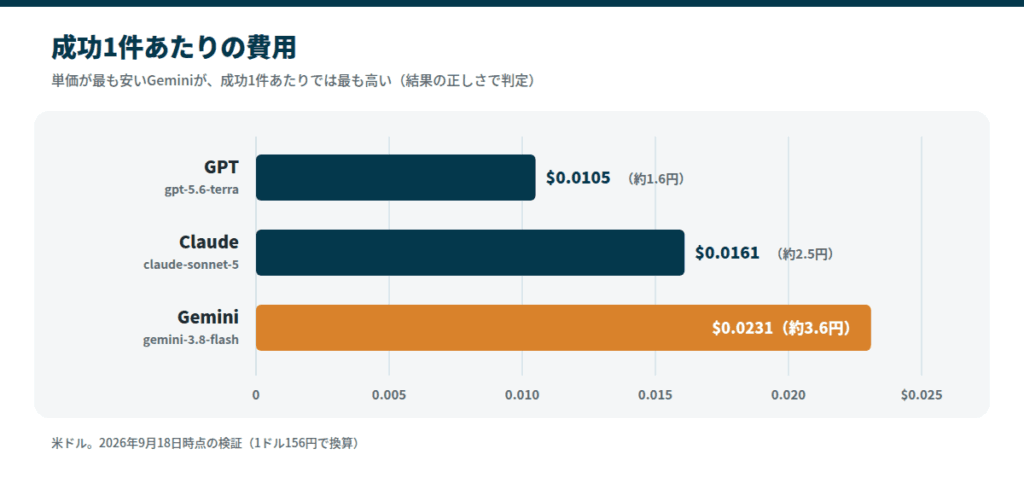
単価表だけを比べても、請求額は読めません。自社の業務で「成功1件あたりいくらか」を一度測るのが確実です。
処理時間と連続稼働
タスクが終わるまでの時間の計測結果です。p95は、全体の95%がこの時間内に収まる値です。
| モデル | 中央値 | p95 | 最大 |
|---|---|---|---|
| Claude | 5.0秒 | 17.1秒 | 89.9秒 |
| GPT | 4.6秒 | 16.4秒 | 69.1秒 |
| Gemini | 6.3秒 | 22.0秒 | 77.4秒 |
中央値が5秒前後なのは、単発タスクが全体の半分を占めるためです。やり取りが10往復を超えるエージェントタスクでは、どのモデルも1分以上かかることがあります。
長時間続けて動かしたときの安定性も確かめました。エージェントタスク5件を約60分おきに3回実行したところ、結果の正しさは3モデルとも15/15(100%)でした。手順の遵守では、GPTが15件中12件でした。
約2時間の連続稼働で、時間がたつにつれて精度が落ちる様子は見られませんでした。
用途ごとのモデルの使い分け
検証の結果から、当社は業務システムで使うモデルを、処理の種類ごとに振り分けています。あわせて、この検証で確かめていないことも書いておきます。
当社の使い分けの決まり
各モデルの得意分野を比べた結果、当社の決まりは次のとおりです。
| 用途 | 選ぶときの基準 | 当社の選び方 |
|---|---|---|
| 分類・抜き出し・要約(単発タスク) | 費用を重視。安いモデルで十分に動く | GPTかGemini |
| 書き込みを伴うエージェント | 止まるべき場面で止まれるかを最優先 | Claudeを第一に |
| 取引先に送る文章 | モデルの差より、人の確認を前提にする | 特定のモデルに頼らない |
| 費用の見積り | 単価表ではなく、成功1件あたりの費用で試算 | キャッシュの効き方も含めて判断 |
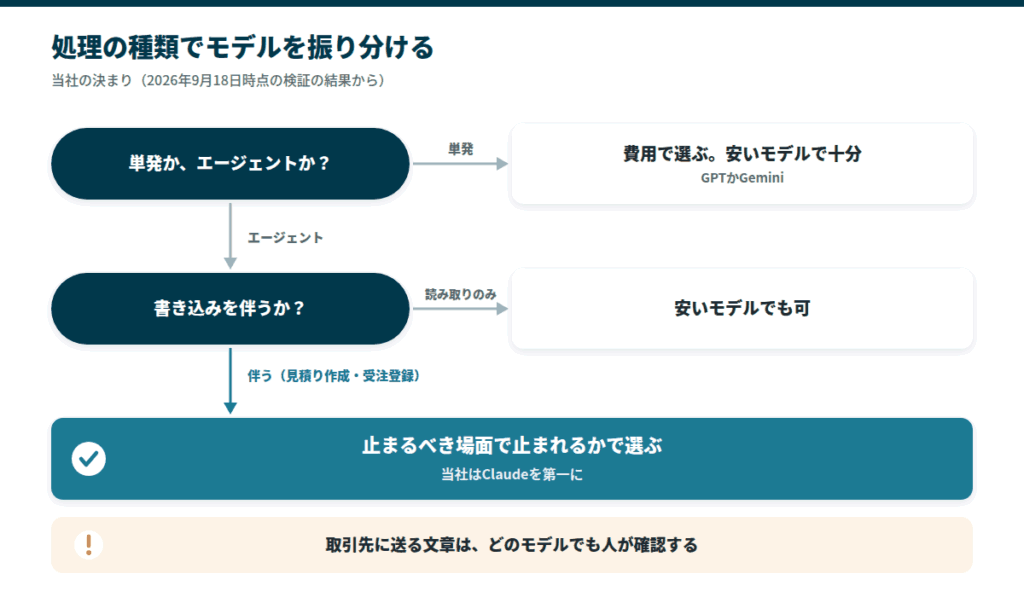
システム全体を一つのモデルに頼る必要はありません。処理の性質に応じて、呼び出すモデルを振り分けるのが当社のやり方です。
アプリの側のコードを変えずに、間に置いたプロキシでモデルを切り替える方法は、次の記事で紹介しています。部署や用途ごとに予算を分けたい場合は、LLMゲートウェイの比較も参考になります。
 久野
振り分けの表は、モデルを入れ替えるたびに見直すものです。同じタスクをもう一度流せるよう、検証の仕組みを残しておくと安心です。
この検証に含まれていないこと
公平のため、この検証で確かめていないことも書いておきます。
- 時間帯による性能の差:連続稼働は約2時間までで、数日にわたる昼夜の差は見ていない
- 通信エラーのときの再試行:APIのエラーからの自動の立ち直りは条件から外した
- とても長い入力:20万トークンを超える入力での動きは確かめていない
- 画像・音声・PDF:読み取りの精度は対象外
また、検証したのは2026年9月18日時点のモデルです。今のSonnet 5.5やGPT-6.1 Solで同じ結果になるとは限らないため、使うモデルが替わったら測り直してください。
まとめ
- 中位のモデルでは結果の正しさの差は小さく、差は手順の遵守と止まり方に出た
- 単価が最も安いGeminiが、成功1件あたりでは最も高かった(約3.6円)
- 単発は安いモデル、書き込みを伴う処理は止まれるモデル、社外の文章は人の確認
中位の価格帯では、主要3社のLLMはどれも、業務のタスクをおおむね正しくこなせる水準にあります。だからこそ、知名度やベンチマークの数字ではなく、次の三点で選ぶことが大切です。
- 業務の確認の手順を、途中で省かないか?
- エラーや異常なデータに出会ったとき、止まれるか?
- キャッシュを含めて、成功1件あたりいくらかかるか?
数か月抱えていた問いに、自社のデータで答えを出せました。ただし、LLMの性能や料金は数か月単位で変わります。
導入後も、正しさと費用を毎月確かめてください。点検の進め方は導入後の月次点検でまとめています。