当社のAIエージェントシステムは、外部のLLM APIと連携して動作しています。そのため、接続先の障害や混雑によって応答が途絶えると、システム全体の業務が停止してしまいます。
この停止リスクを防ぐ最も効果的な手立てが、別会社のモデルへ自動で切り替える(フォールバック)仕組みです。経営層には「クラウド依存リスクへの保険」と説明していますが、技術的にはAPIの呼び出し先をプロキシ層で瞬時に切り替える処理であり、サーバー自体を落とさずに稼働を維持できます。
本記事は、LiteLLM Proxy を用いて自動切り替え構成を構築し、実際に疑似障害を起こして検証した記録です。
先に結論を言えば、モデルの自動切り替え自体は正常に機能しました。しかし、設定した機能のうち3つが想定通りに動かず、調整が必要でした。
アプリには自分で決めたモデル名を呼ばせる
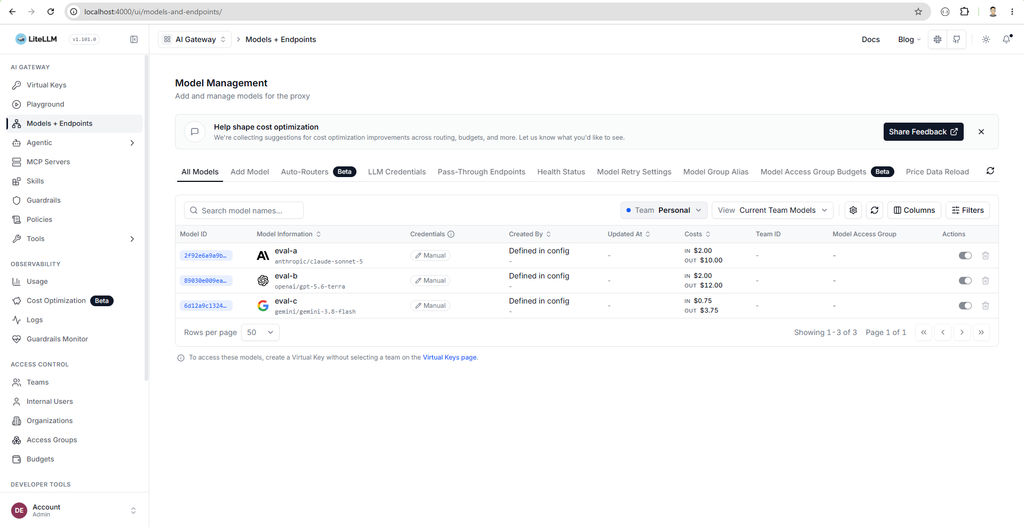
設計における最大のポイントは、アプリケーション側に特定のモデル名(claude-sonnet-5など)を直接書かず、chat-main のような自社で決めたモデル名だけを呼ばせる事です。
LiteLLM では、この名前をモデルグループと呼びます。config.yaml の model_name がそれにあたります。
どのプロバイダーのどのモデルにリクエストを流すかは、すべてLiteLLM Proxy側で制御します。万が一切り替えが発生しても、アプリ側はその事実を意識する必要がありません。プロバイダーの追加・削除時もアプリのコード改修は不要です。
たとえば2026年9月28日に出たClaude Sonnet 5.5(claude-sonnet-5-5)へ切り替える場合も、変えるのは config.yaml の model の1行です。料金はSonnet 5と同じ100万トークンあたり入力2ドル・出力10ドルで、本文の claude-sonnet-5 は、2027年6月30日より前には提供を終えない予定です。
当社の検証用テストハネスでも、3社のモデルを eval-a・eval-b・eval-c という抽象的な名前で呼び出しており、アプリ側のコードには社名もモデルIDも一切登場しません。
| モデルグループ名 | 用途 | 運用イメージ |
chat-main | 業務の本線 | 高精度な推論が必要なメイン処理 |
chat-light | 分類・抽出 | 処理単価の安い軽量モデルで十分なタスク |
chat-heavy | 複雑な判断 | 長文コンテキストや高度な論理的判断 |
このように用途別でモデルグループ名を分けておくと、モデルの入れ替えやコスト最適化を柔軟に行えます。
最小構成と設定ファイルの作成
予算管理を行わない最小構成であればデータベース(DB)なしでも起動可能ですが、今回は仮想キーごとの利用予算上限を設定するため、PostgreSQLを組み込んだ4構成で構築しました。
- LiteLLM Proxy(Port 4000:リクエストの仲介・ルーティング)
- PostgreSQL(仮想キー、利用ログ、予算データの保持)
- Redis(レート制限の管理およびキャッシュ)
- Caddy(HTTPS化用。ローカル検証では省略)
以下が今回使用した config.yaml です。
model_list:
  - model_name: chat-main
    litellm_params:
      model: anthropic/claude-sonnet-5
      api_key: os.environ/ANTHROPIC_API_KEY
      # ※キャシュ設定はここに記述する必要がある(後述)
      cache_control_injection_points:
        - location: message
          role: system
        - location: message
          index: -1

  - model_name: chat-sub
    litellm_params:
      model: openai/gpt-5.6-terra
      api_key: os.environ/OPENAI_API_KEY

  - model_name: chat-backup
    litellm_params:
      model: gemini/gemini-3.8-flash
      api_key: os.environ/GEMINI_API_KEY

router_settings:
  fallbacks:
    - chat-main: ["chat-sub", "chat-backup"]
  num_retries: 1
  allowed_fails: 3
  cooldown_time: 60

litellm_settings:
  request_timeout: 5
drop_params: trueLiteLLMは2026年に脆弱性の公表が続いています。4月のSQLインジェクション(CVE-2026-42208)と、MCPの認証の欠陥(CVE-2026-42271・CVE-2026-59822)は、米国のCISAが悪用を確認した脆弱性の一覧に載っています。イメージをダイジェストで固定している場合は、公表のたびに版を上げ直してください。
フォールバックの種類と設定ルール
LiteLLMのフォールバック設定には3種類存在します。通常の混雑・障害対策で利用するのは1つ目です。
| 設定項目 | 発動条件 | 設定の記述場所 |
fallbacks | レート制限(429)、5xxエラー、タイムアウト | router_settings |
context_window_fallbacks | コンテキスト長の上限オーバー | litellm_settings |
content_policy_fallbacks | コンテンツポリシー(安全フィルタ)による拒否 | litellm_settings |
後者2つは運用フェーズで効果を発揮する機能です。今回の検証では1つ目の fallbacks を中心に確認しました。
実測で分かった「3つの落とし穴」
設定を済ませ、実際にシステムを破壊して切り替え動作(カオスエンジニアリング試験)を行った結果、3つの落とし穴が判明しました。
※なお、以前提供されていた mock_testing_fallbacks パラメータはProxy v1.85.0以降でリクエストAPIから削除されています。現在のProxy環境では、実際にAPIキーを無効化するか、存在しないホストへ向ける形でテストを行います。
落とし穴①:キャッシュ設定の「記述階層ミス」でエラーが出ずに課金が急増する
最も時間を取られたのがPrompt Cachingの設定でした。
ClaudeのOpenAI互換呼び出しでは、自動で cache_control が付与されないため、LiteLLMの自動挿入機能を利用します。
この設定を litellm_params の外(ルート階層など)に記述してしまうと、設定が無効化されます。恐ろしいのは、構文エラーが出ず正常に動いてしまう点です。結果としてキャッシュが一切効かず、コストだけが跳ね上がります。
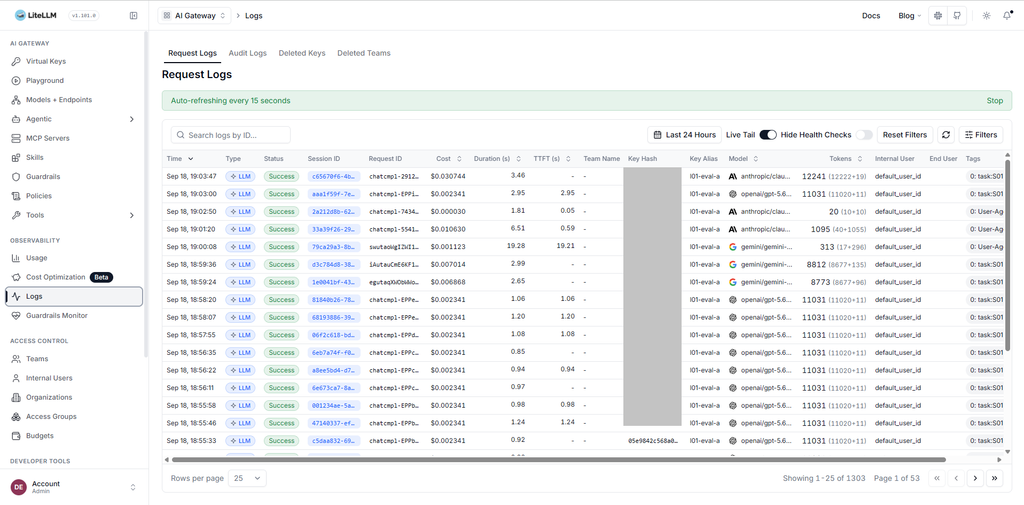
【10件の予備実行による実測比較】
| モデル | 入力トークン数 | キャッシュ読み取り数 | 実行費用 |
| Claude(設定記述ミス時) | 449,934 | 0 | $0.96 |
| GPT(デフォルトで適用) | 331,566 | 305,584 | $0.15 |
記述場所を litellm_params 内部へ修正したところ、エージェント1実行あたりの費用は $0.143 から $0.058 へと大幅に激減しました。
キャッシュ指定は、システムプロンプト・ツール定義を保持する system と、ターン毎に伸びる会話履歴を保持する最後のメッセージ(index: -1)の2箇所に入れるのがベストプラクティスです。キャッシュが機能しているかはログの「キャッシュ読み取り数」でしか確認できないため、納品前の数値確認が必須となります。
なお、この実測はSonnet 5(claude-sonnet-5)で行ったものです。Sonnet 5.5では、キャッシュできる最小の長さが512トークンで、Sonnet 5の1,024トークンから下がったため、同じ構成でも数字は変わります。
落とし穴②:単一デプロイ構成では「クールダウン」が機能しない
障害発生時、連続して失敗したメインモデルを一時的にローテーションから外すため allowed_fails: 3 および cooldown_time: 60 を設定していました。しかし実測では主モデルが一度も切り離されませんでした。
主モデルのAPIキーを効かなくした状態で10回連続呼び出しを行った結果、10回とも attempted_fallbacks は 1 のままでした。つまり、毎回必ず失敗する主モデルを試してから、副モデルへ回る動きを繰り返していたのです。
失敗時の呼び出し所要時間
- 1〜10回目の試行: 11.7秒 〜 14.8秒(中央値:約12.3秒)
- 60秒経過後の11〜13回目: 12.2秒 〜 13.4秒
毎回約12.3秒かかっている理由は、主モデルへのタイムアウト(request_timeout: 5)を num_retries: 1 で2回試行(計10秒)した後に副モデルへ切り替わるためです。エージェントが1タスクで4回LLMを呼ぶ場合、全体で約48秒もの遅延が上乗せされます。
原因と対策
LiteLLMのクールダウン機能は、「同じモデルグループ内に複数のデプロイ(例:Azure OpenAIと本家OpenAIなど)が存在する場合の振り分け」を想定した仕組みです。今回のように1つのモデルグループ名に1つのデプロイしか紐づいていない単一構成では、除外する代替先がないためクールダウンが働きません。
単一デプロイ構成における現実的な混雑・障害対策は以下の通りです。
request_timeoutを短く設定する(例:3〜5秒)num_retriesは0または1に抑える(リトライ回数を増やすほどタイムアウト待ち時間が足し合わされる)- 単一デプロイ構成では
allowed_fails/cooldown_timeに依存しない
落とし穴③:ストリーミングの途中切断は「正常成功」として処理される
ストリーミング応答時における障害挙動をテストしたところ、深刻な課題が見つかりました。
| テスト状況 | エラー発生条件 | 検証結果 |
| ① 最初のトークン受信前 | 主モデルが接続不可 | 正常に副モデル(Gemini)へ切り替わり応答(初回トークンまで20秒) |
| ② 応答速度の低下 | 主モデルの応答が遅延 | タイムアウト判定されず主モデルがそのまま完走(11秒・1,891文字) |
| ③ 応答途中の切断 | SSEを5チャンク送信後に切断 | 切り替わらず、エラーも発生しない(異常) |
特に問題なのが「③ 応答途中の切断」です。数文字受け取った時点でプロキシから finish_reason: stop が返され、例外が発生しませんでした。フォールバック回数(fallbacks)も 0 であり、アプリ側からは正常に完了したように見えてしまいます。
同じ障害状態で stream=false(通常呼び出し)にすると、正しく副モデル(GPT)へ切り替わって完全な回答が返ってきました。
人間が読むチャットUIであればユーザーが不自然な途切れに気付けますが、JSON等を解釈するAIエージェントの場合は構文エラーや処理欠損を引き起こします。ストリーミングを使用する場合は、出力が意図した形式で完了しているかをアプリ側で検証するガードレールが不可欠です。
運用上で落とし穴になりやすい注意点
切り替え先モデルの機能・スペックの互換性
フォールバック先へ接続できても、モデルの機能差で落ちるケースがあります。主モデルと副モデルの間で以下の互換性が保たれているか事前にテストしてください。
- Tool Calls(関数呼び出し)に対応しているか
- JSON Schemaによる構造化出力(Structured Outputs)に対応しているか
- 十分なコンテキストウィンドウ(文脈長)を持っているか
当社の検証では、3社のモデル間で10ターンの対話を途中で切り替えるテストを実施しました。全パターンで会話の継続・ツール呼び出し・構造化出力が成功することを確認しています。ただし、会話履歴を別プロバイダーへ再送するため、入力トークン量と所要時間は一時的に増加します。
Sonnet 5.5へ切り替える場合は、このテストをやり直してください。Sonnet 5.5では思考が最初から有効になり、max_tokens に思考の分も入ります。また、temperature・top_p・top_k を既定以外の値にする指定と、tool_choice でツールを強制する指定(any・tool)は、エラー(400)になります。
費用請求のアカウントとプロキシ上の予算管理
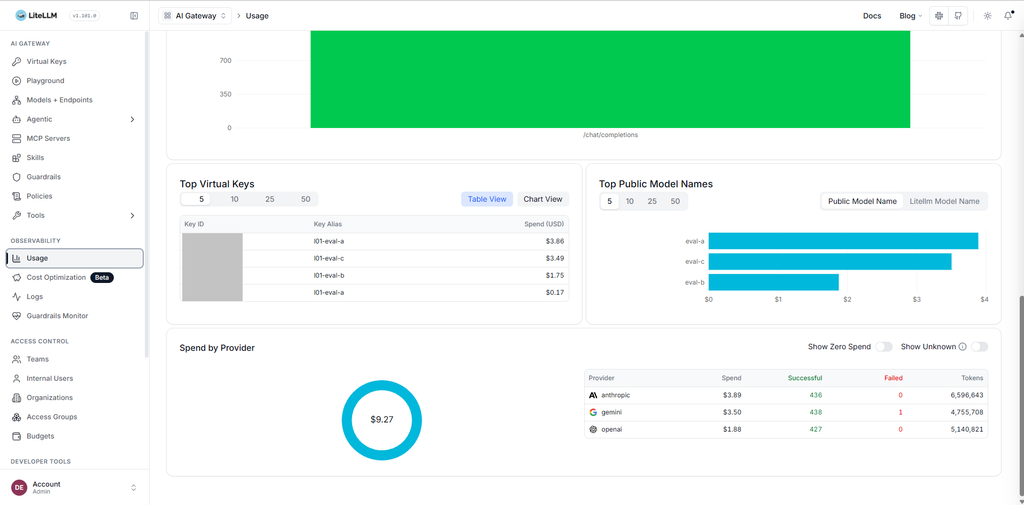
フォールバックが発生すると、実費の請求先とプロキシ上の集計にズレが生じます。
- 実際の請求
切り替え先(例:OpenAI)のプロジェクトアカウントに届く - LiteLLM上の集計
リクエスト時に指定した主モデル用「仮想キー(Virtual Key)」の予算から引かれる
単価の高いモデルへ切り替わった場合、一気に実費が跳ね上がるリスクがあります。マスターキーはアプリに配布せず、以下のように上限を設定した仮想キーを発行して運用してください。
なお、2026年8月26日に、仮想キーを持つ利用者がリクエストに差し込んだ値で、各社のAPIキーを抜き出せる不具合が公表されました。1.96.2で直っているため、仮想キーで運用する場合は、この版以降を使ってください。
curl -X POST "$LITELLM/key/generate" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "key_alias": "eval-a",
    "models": ["eval-a"],
    "max_budget": 9,
    "budget_duration": "30d"
  }'
動的な切り替えと運用監視
運用監視でログ確認すべき3項目
外形監視(ヘルスチェック)だけでは「主モデルが落ちたまま副モデルで動き続けている状態」を検知できません。ログから以下の指標を常時モニタリングします。
- 実際に応答したモデル(
served_model) - 切り替えが発生した回数(
fallbacks) - キャッシュの読み取り成功量
日次で応答モデルの比率を集計し、主モデルのダウンが長期化していないか確認します。
コンテナを再起動せずに切り替える方法
緊急時、設定ファイルを書き換えてコンテナを再起動する余裕がない場合は、LiteLLMのエンドポイントへ直接リクエストを送ることで動的に切り替え先を変更できます。
curl -X POST http://localhost:4000/fallback \
  -H "Authorization: Bearer sk-<マスターキー>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "chat-main",
    "fallback_models": ["chat-sub"],
    "fallback_type": "general"
}'※動的変更後は、障害復旧後に忘れずに config.yaml へ変更内容を反映させてください。
本番投入前のチェックリスト
本番環境(VPS等)へデプロイする前に、以下の項目を必ずチェックしてください。
- コンテナのバージョンタグ(SHA256ダイジェスト)を固定し、脆弱性の公表のたびに版を上げ直しているか
- Proxyの 4000 番ポートを外部へ直接露出させていないか
- アプリにはマスターキーではなく、仮想キー(Virtual Key)のみを配っているか
- 仮想キーに利用予算上限(
max_budget)と有効期限(budget_duration)を設定したか - APIキーを意図的に無効化し、副モデルへ正しく切り替わるか実測したか
- 主・副の両方を同時に無効化し、3段目(予備モデル)まで届くか確認したか
- 切り替え先のモデルで Tool Calls や JSON 構造化出力が正常動作するか
- キャッシュが適用されているか(ログのキャッシュ読み取り数で確認)
- ストリーミング使用時、出力完了をアプリ側で検知・検証しているか
- 単一デプロイ構成で
allowed_failsやcooldown_timeに依存した設計になっていないか num_retries設定時のタイムアウト増加時間を把握しているか- 応答モデルの割合(
served_model)を日次で可視化・監視する仕組みがあるか - PostgreSQL の自動バックアップを設定したか
/health/livelinessエンドポイントを外形監視に組み込んだか
まとめ
アプリからLLMをモデルグループ名で呼び出す設計にすることで、モデルの自動切り替え処理はプロキシ側へ綺麗に集約できます。
しかし、今回の検証で明らかな通り、単に設定ファイルを記述しただけでは機能しません。
- キャッシュ設定の記述位置ミス(エラーが出ない罠)
- 単一デプロイ構成におけるクールダウンの不発
- ストリーミング途中切断時の偽の正常終了
実際に障害を発生させて動作を検証するところまでが、フォールバック構成構築の必須プロセスです。
この記事は2026年9月に、Claude Sonnet 5.5の公開とLiteLLMの脆弱性の公表に合わせて見直しました。
本記事で扱っていないこと
- 顧客VPSへの本番設置手順(CaddyでのHTTPS化、ドメイン設定、バックアップ運用など)
- 複数レプリカ構成および1グループ複数デプロイ構成の構築
context_window_fallbacksやcontent_policy_fallbacksの詳細検証- 実際の 429(Rate Limit)大量発生時の挙動検証


